画像の中の物を見つけ、輪郭まで切り出す作業を現場に載せるとき、いちばん時間がかかるのはモデルそのものより データの往復 です。COCO で取って、YOLO で試し、LabelMe で直し、学習は別の実行環境、評価はまた別のスクリプト ― 同じ仕事なのに形式と環境が割れ、昨日の操作を今日もう一度やれない。
RecogStudio は、その散らばりを一本の流れにまとめた、当社の認識開発の環境です。受け渡しの基準は LabelMe 形式です。取り込みも、自動での印つけも、学習も評価も、この形式を軸につなぎます。画面は入り口で、本体の処理はコマンドです。画面で押したボタンは、同じコマンドとして再現できます。画面にしかない機能は作りません。
バラバラだった開発を、一本のパイプラインに
認識開発が遅れる理由は、だいたい次の4つです。
- 散在するスクリプト ― 学習・推論・評価が別々の置き場に増え、どれが正かが分からない。
- 環境が割れる ― 重いライブラリごとに実行環境が違い、同じデータを別手順で回す。
- 形式の往復 ― COCO・YOLO・LabelMe をその都度、手で変換する。
- 再現できない画面操作 ― 画面でやったことがログに残らず、翌朝もう一度同じ手順を回せない。
RecogStudio の答えは単純です。LabelMe 形式を共通の受け渡しにして、変換・学習・評価をつなぐ。画面は入り口で、本体の処理は同じコマンドです。
9ステップ。左ナビを進めるだけ
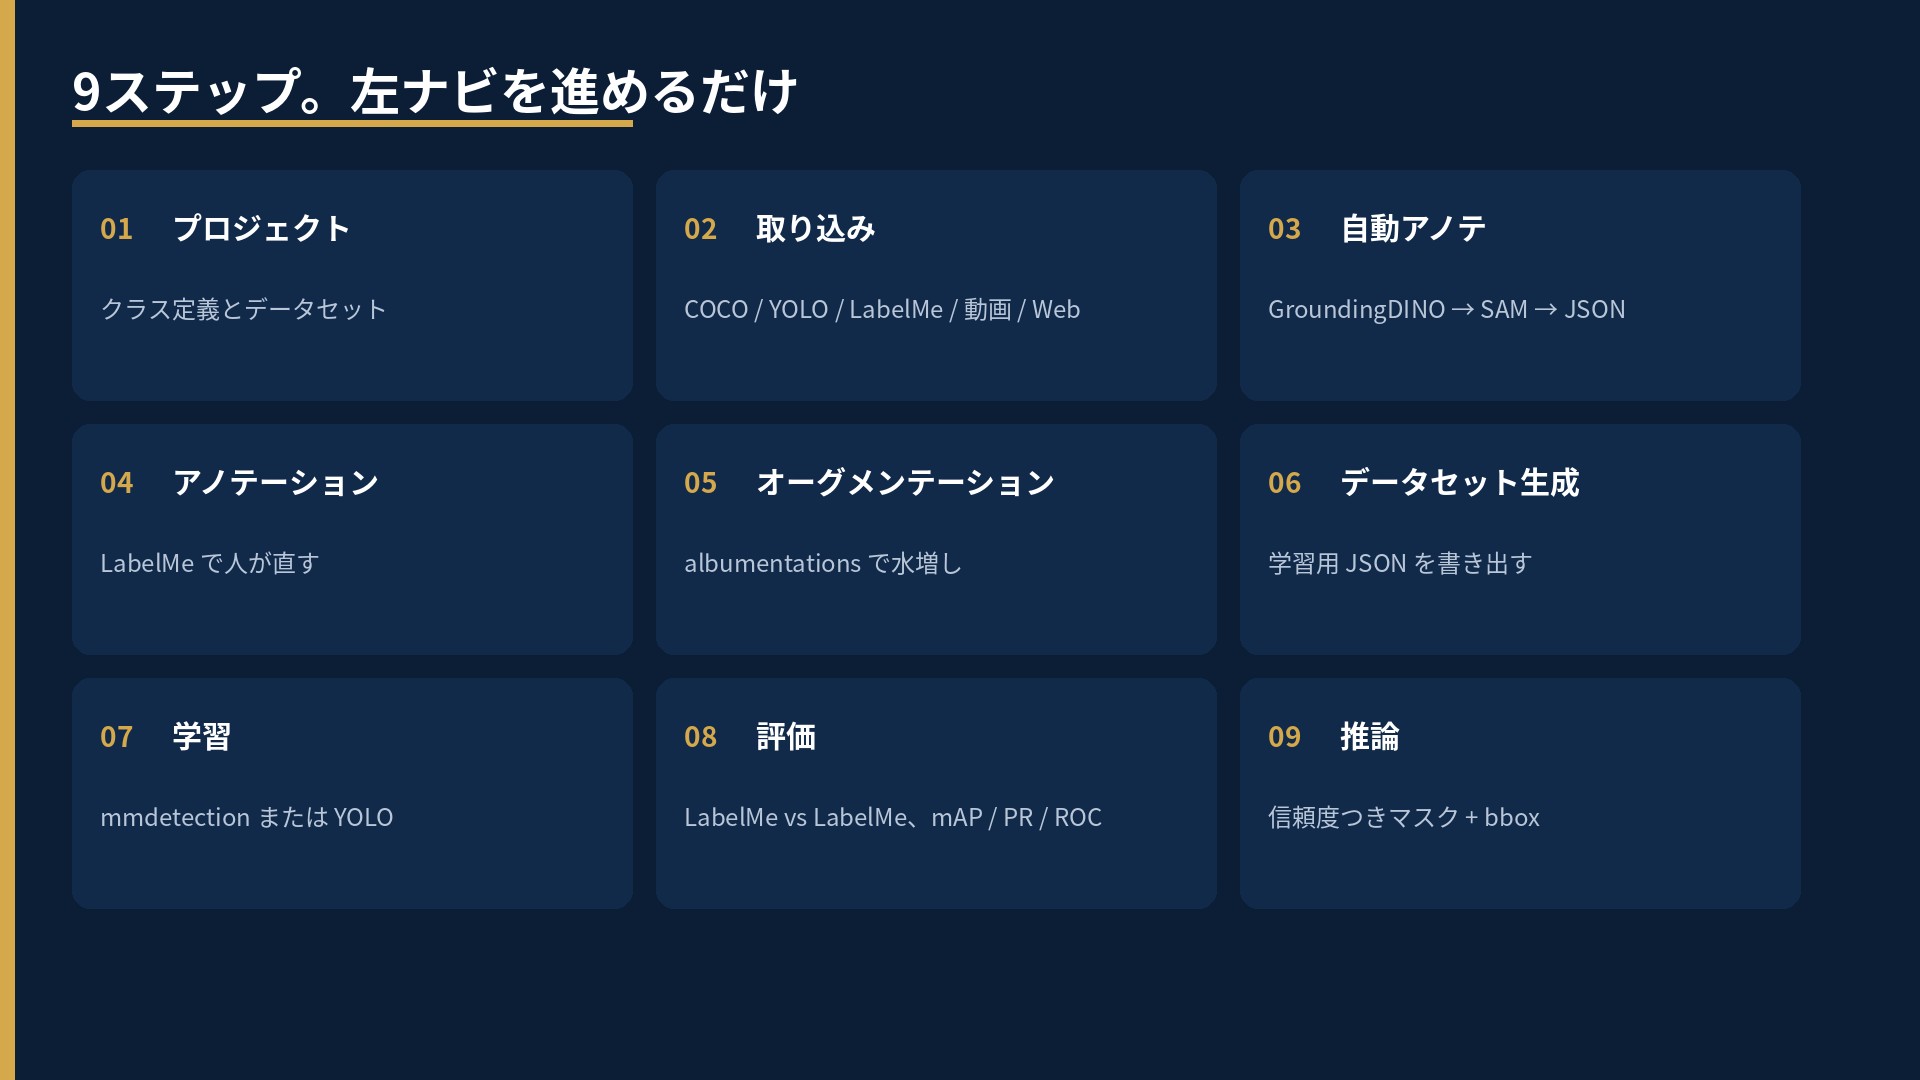
画面の左ナビが、そのまま作業順です。プロジェクトを開き、上から下へ進める。
| ステップ | やること |
|---|---|
| 01 プロジェクト | クラス定義とデータセットを置く。LabelMe のラベル名が GroundingDINO のプロンプト/COCO・YOLO の id 順になる |
| 02 取り込み | COCO / YOLO / VOC / LabelMe / 動画 / Web から入れる。どの形式でも内部は LabelMe |
| 03 自動アノテ | GroundingDINO で検出し、SAM で多角形マスク、LabelMe JSON に書く |
| 04 アノテーション | LabelMe で人が直す。自動アノテはたたき台 |
| 05 オーグメンテーション | albumentations で水増し |
| 06 データセット生成 | 学習用 JSON(COCO 等)を書き出す |
| 07 学習 | mmdetection または YOLO。学習済みは推論・評価から選べる |
| 08 評価 | LabelMe(GT)vs LabelMe(Pred)。mAP / PR / ROC / 混合行列 |
| 09 推論 | 信頼度つきマスク + bbox。結果は LabelMe JSON にも戻せる |
ほかプロジェクト/LabelMe 拡張/データセット/評価/推論も、同じ画面の中にあります。ツールを渡り歩かないのが目的です。
クラス名を書く。マスクが返る
自動アノテーションは、検出したい名前をプロンプトに書くところから始まります。person / car / bench のようにクラス名を書けば、矩形が返り、輪郭が切り出されます。
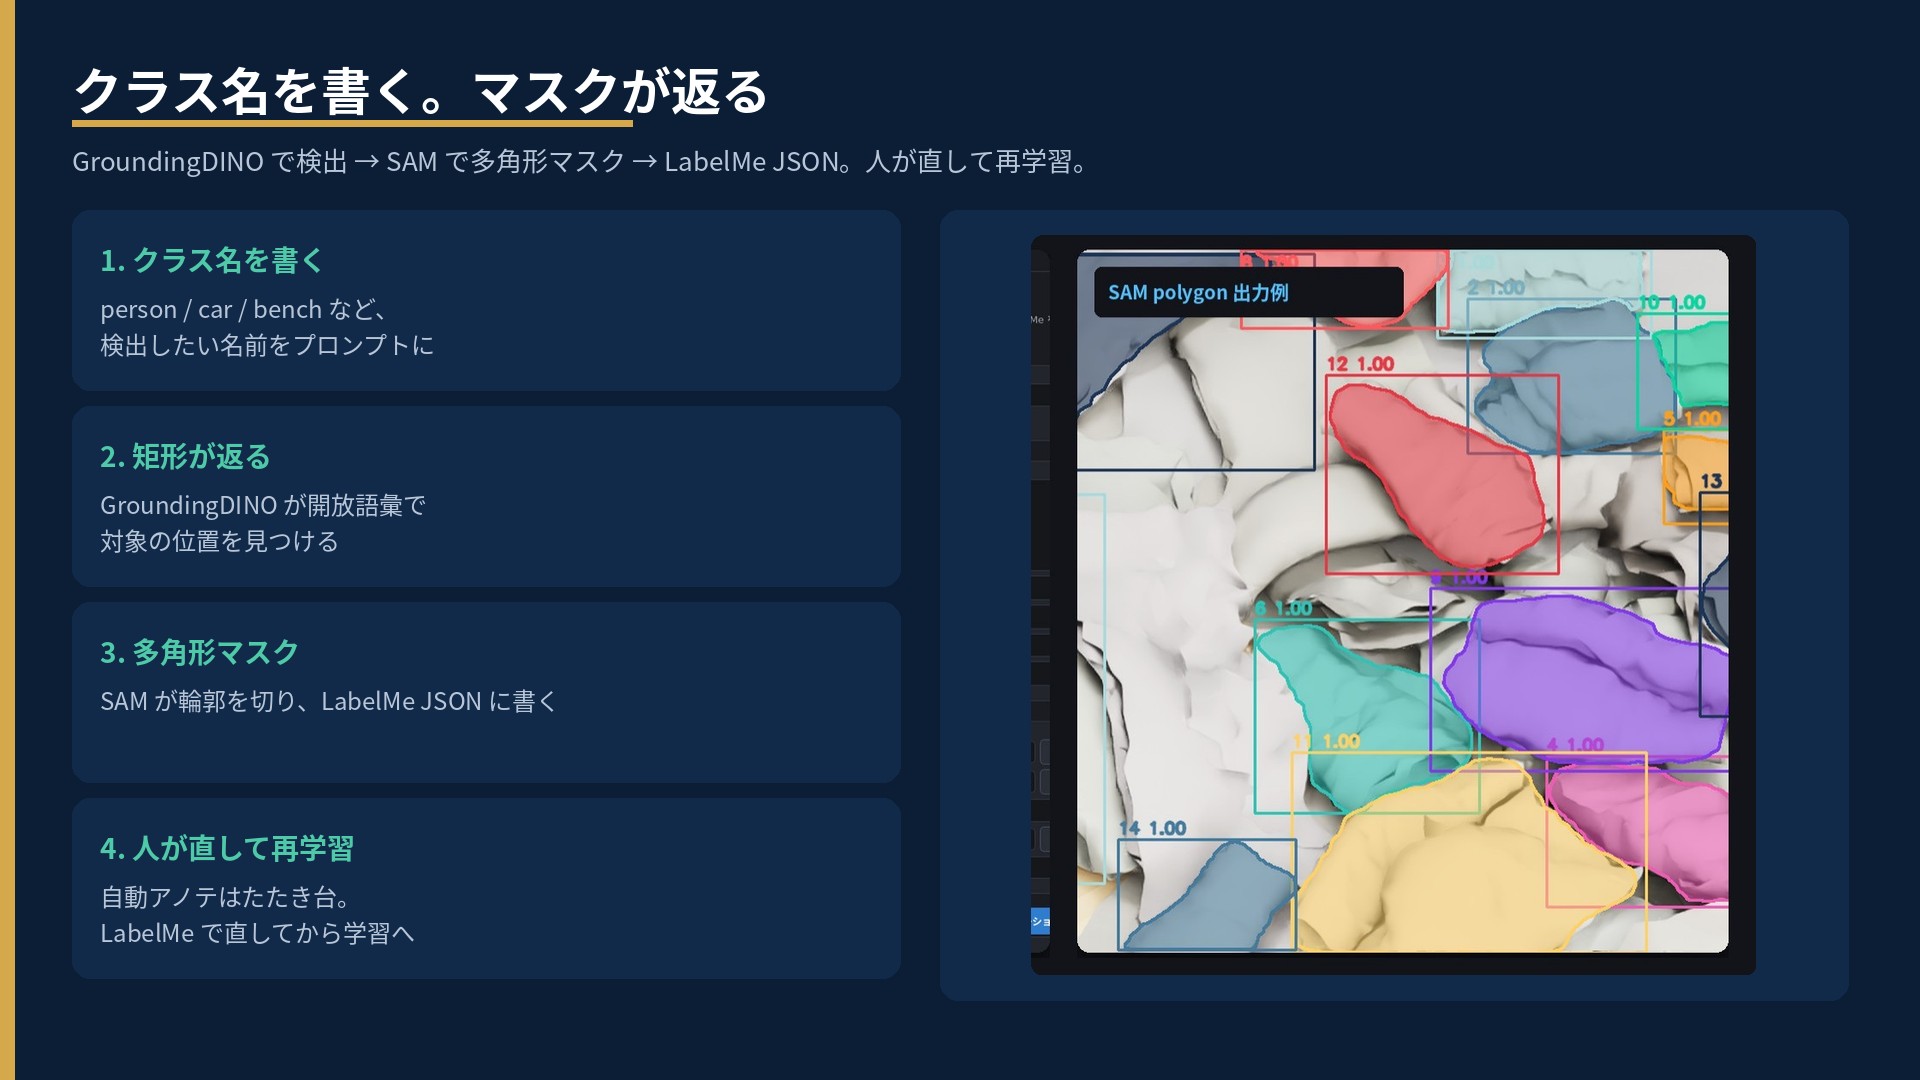
流れは4つです。
- クラス名を書く ― 検出したい名前をプロンプトに。
- 矩形が返る ― GroundingDINO が、あらかじめ決めた種類以外も含めて対象の位置を見つける。
- 多角形マスク ― SAM が輪郭を切り、LabelMe JSON に書く。
- 人が直して再学習 ― 自動アノテはたたき台。LabelMe で直してから学習へ。
ゼロから全部手で塗る必要はありません。ただし、人が見て直す前提です。ここを飛ばすと、学習は速いが現場で壊れます。
推論は、見た瞬間に伝わる
学習したモデルの出力は、信頼度つきのマスクと bbox です。Mask R-CNN / Faster R-CNN 系の個体セグを、画面上でそのまま確認できます。
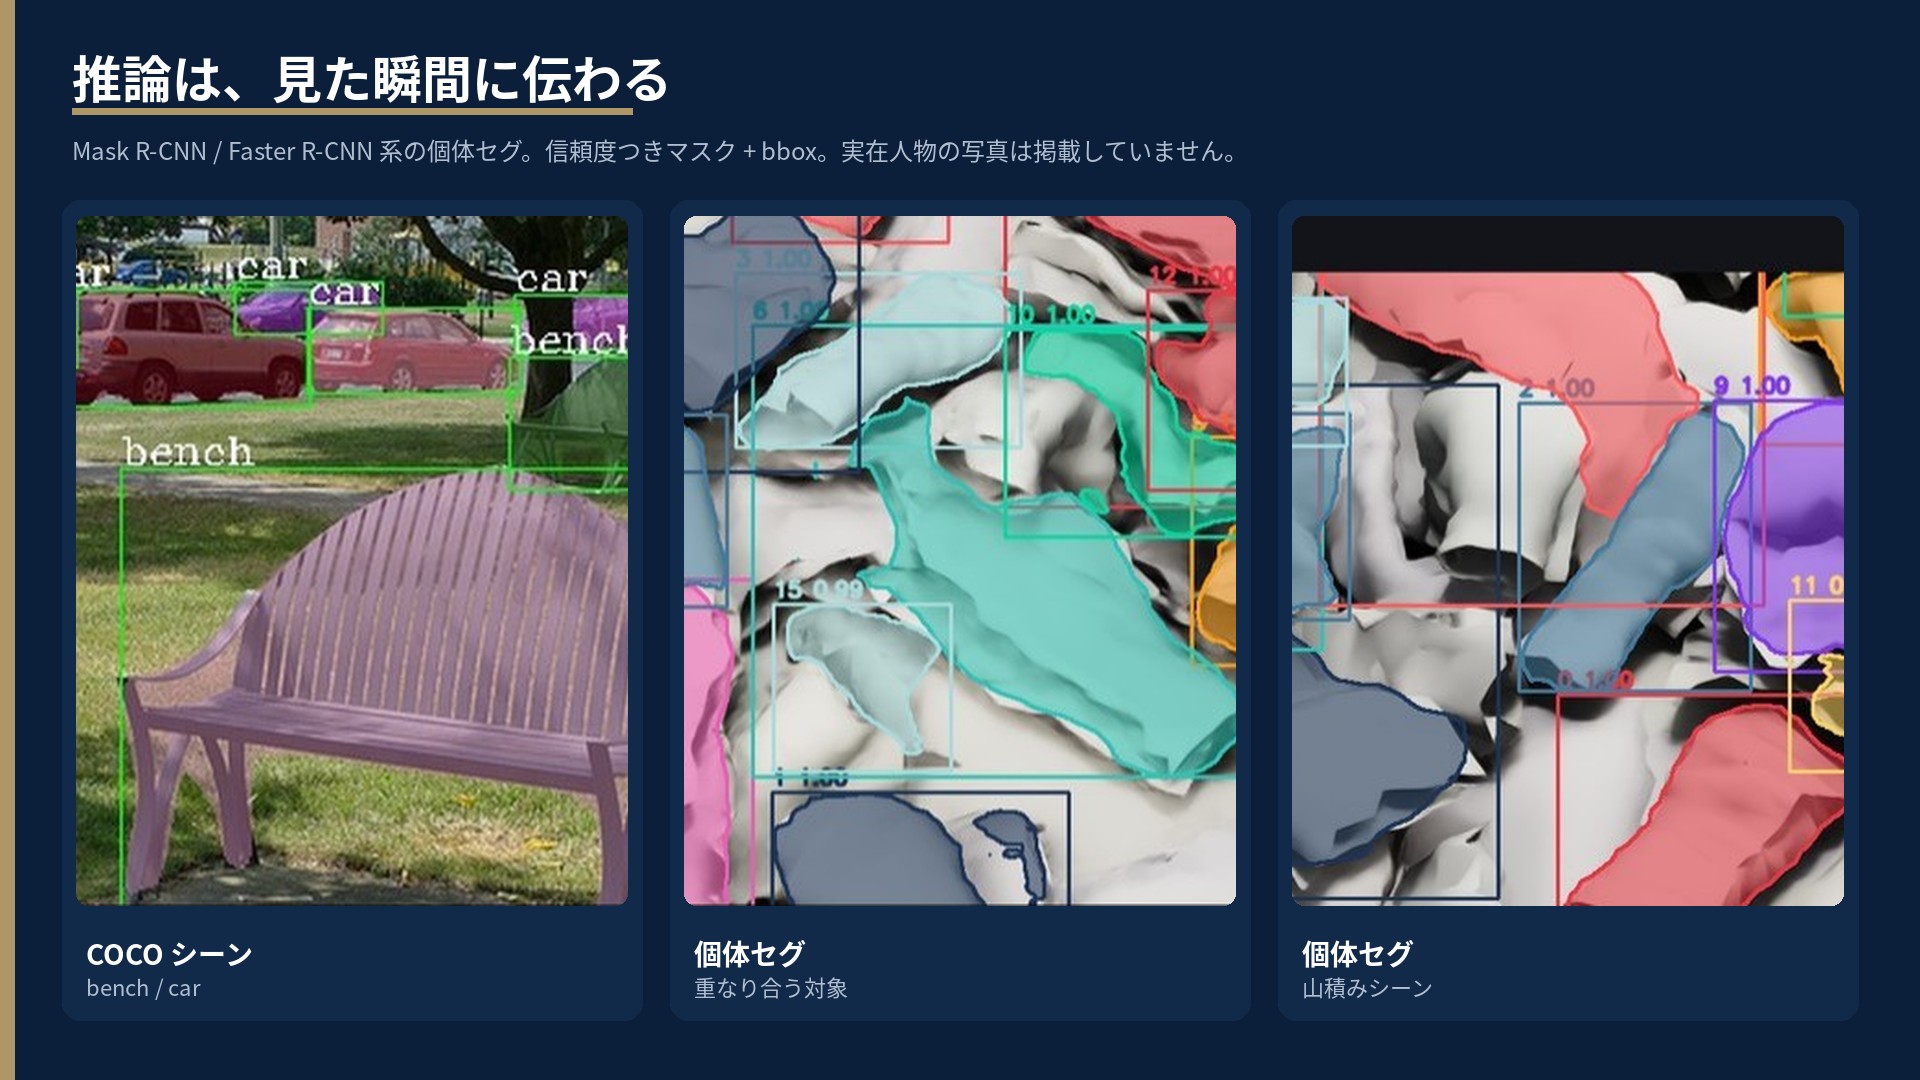
ポイントは、推論結果が 次のステップの入力になる ことです。Pred を LabelMe に戻せば、評価(GT vs Pred)にも、誤検出の手直しにも使えます。「推論して終わり」ではなく、パイプラインの一部です。
学習は2系統。評価は LabelMe vs LabelMe
学習バックエンドは2つです。精度寄りの実験は mmdetection 3.3(Mask R-CNN / Faster R-CNN / ViTDet)、軽い実験は ultralytics YOLO。テンプレート config を上書きして学習します。
評価は枠に依存しません。GT も Pred も LabelMe で突き合わせ、mAP・クラス別 AP・HTML レポートを出します。学習側が mmdet でも YOLO でも、評価の見かたは同じです。
見るべき数字は、mAP だけではない
個体セグの実測(val 144枚 / 3,935 inst、epoch 10、40本学習)では、bbox と mask を並べて見ます。
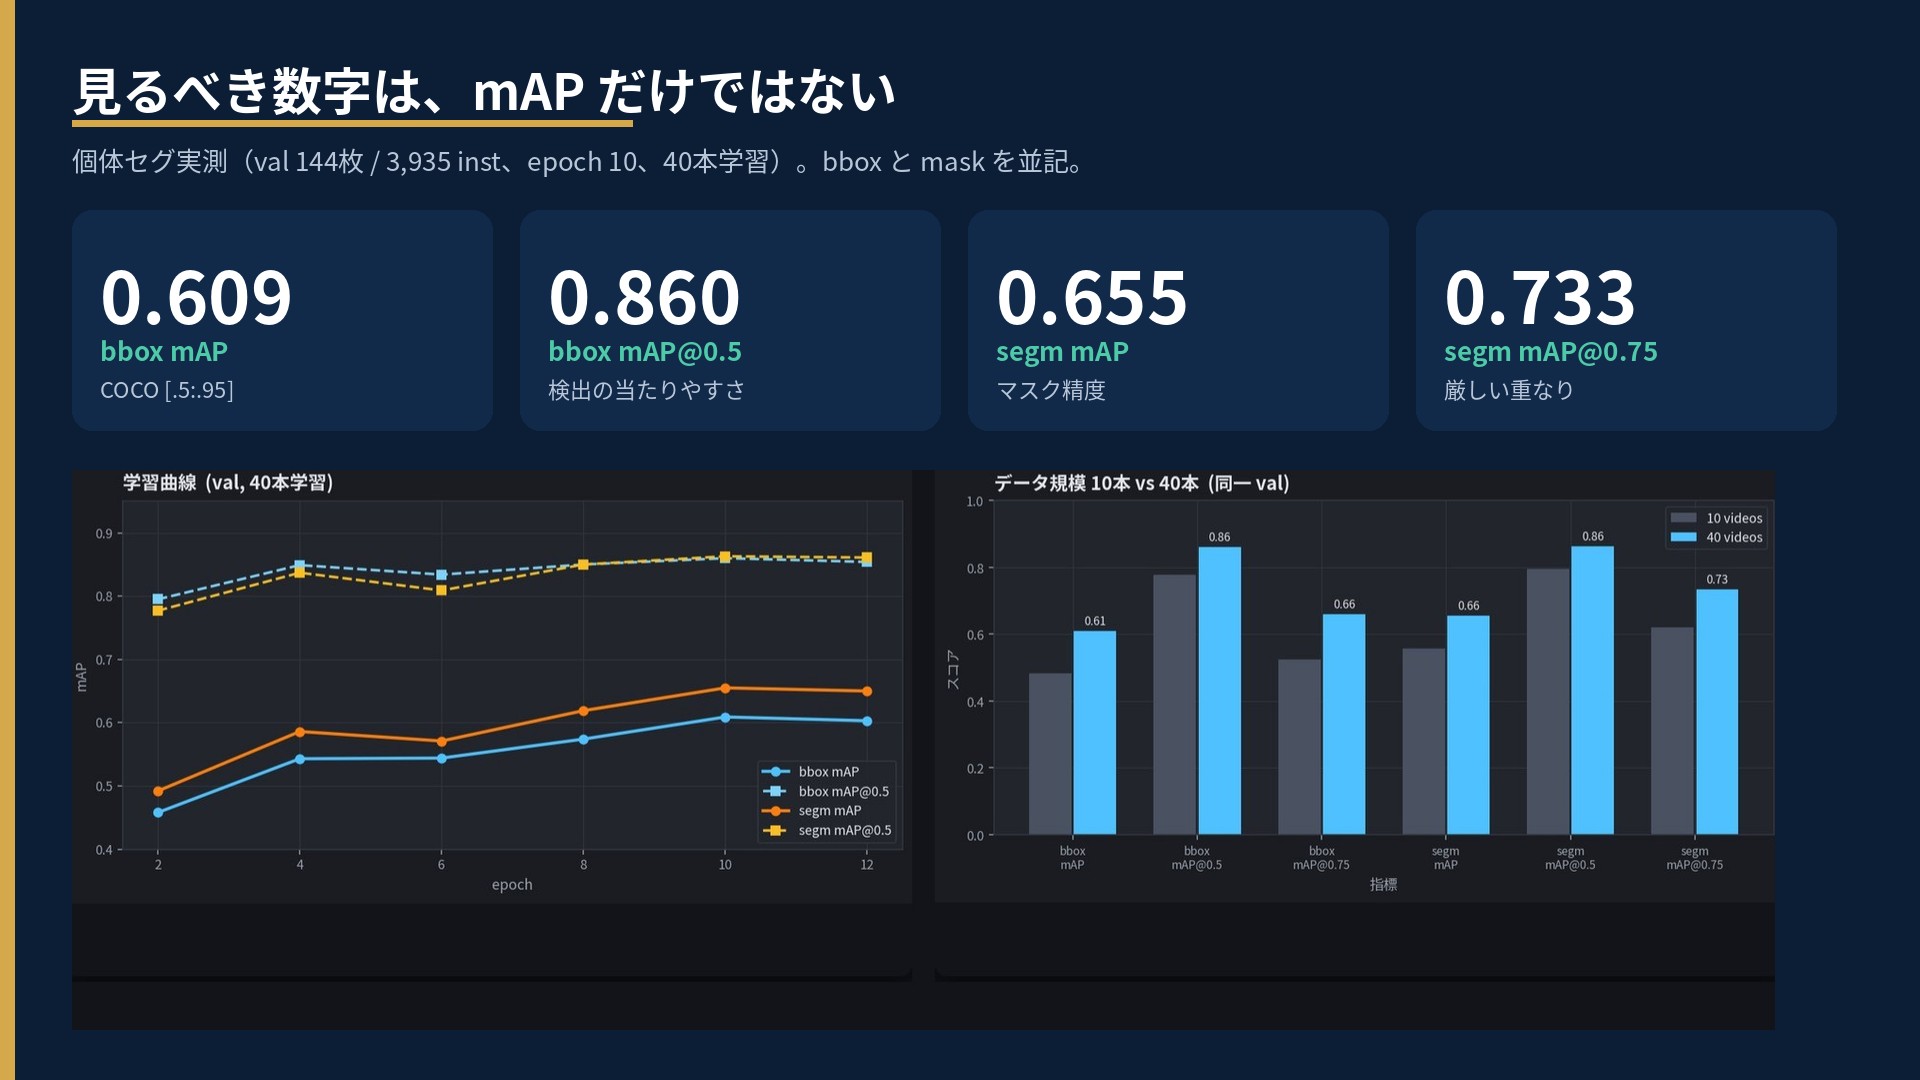
| 指標 | 値 | 見かた |
|---|---|---|
| bbox mAP | 0.609 | COCO 公式の [.5:.95]。総合力 |
| bbox mAP@0.5 | 0.860 | 検出の当たりやすさ |
| segm mAP | 0.655 | マスク精度 |
| segm mAP@0.75 | 0.733 | 厳しい重なりにどれだけ耐えるか |
mAP@0.5 だけを追うと「当たっている」ように見えて、輪郭が甘いことがあります。逆に segm@0.75 が伸びていれば、重なりの切り分けが進んでいます。RecogStudio は、この並びを学習曲線とデータ規模比較と一緒に出します。
動作点を切る。クラスの弱点を見る
本番タスクでは COCO 公式 mAP も併用しますが、運用の動作点は Precision / Recall / F1 で切ります。下図は同じ計算のサンプル(家具クラス、85枚)です。
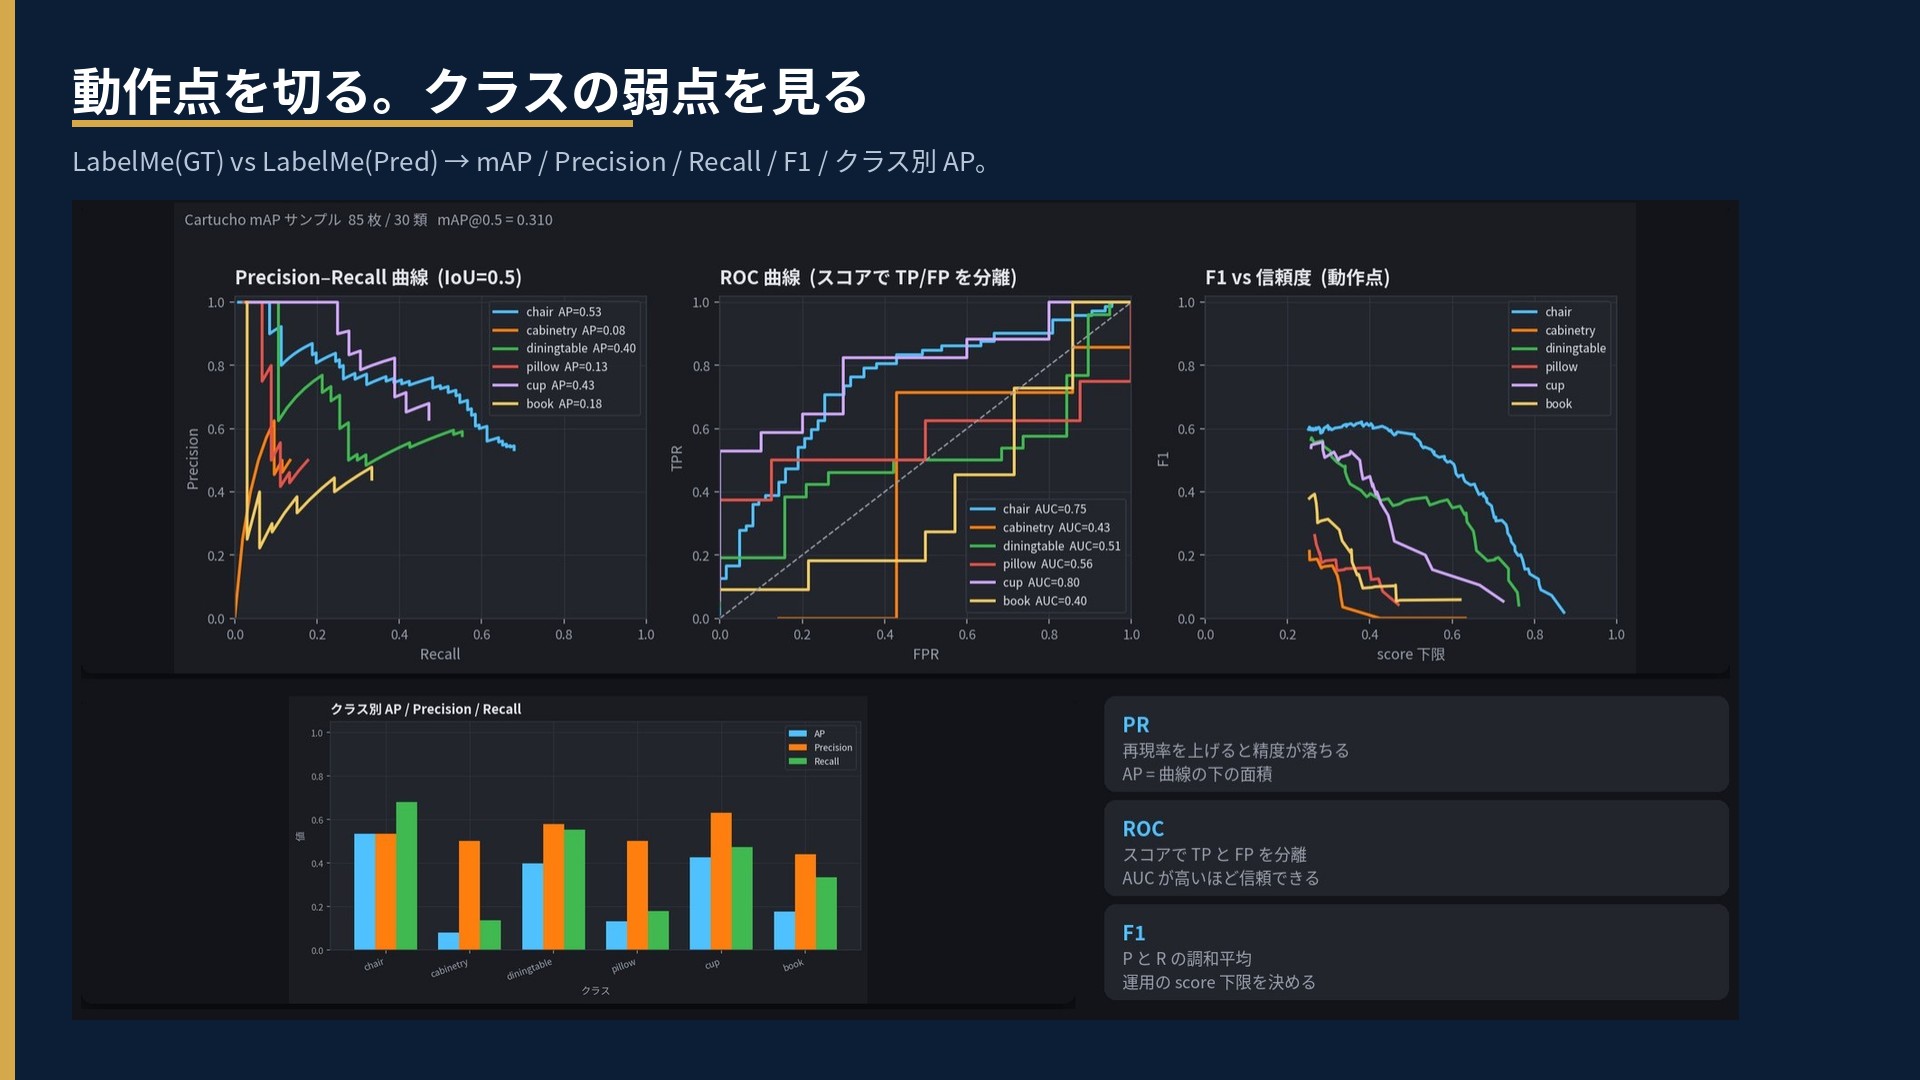
- PR ― 再現率を上げると精度が落ちる。AP は曲線の下の面積。
- ROC ― スコアで TP と FP を分離。AUC が高いほど信頼できる。
- F1 ― Precision と Recall の調和平均。運用の score 下限をここで決める。
「平均は良いが cup だけ落ちる」といった話は、クラス別 AP を見ないと分かりません。平均 mAP だけをレポートに書かない、というのがこの画面の意図です。
どこを間違えたか。混合行列で見る
数字の次は、どこを間違えたか です。行が正解、列が予測。対角が当たった数です。
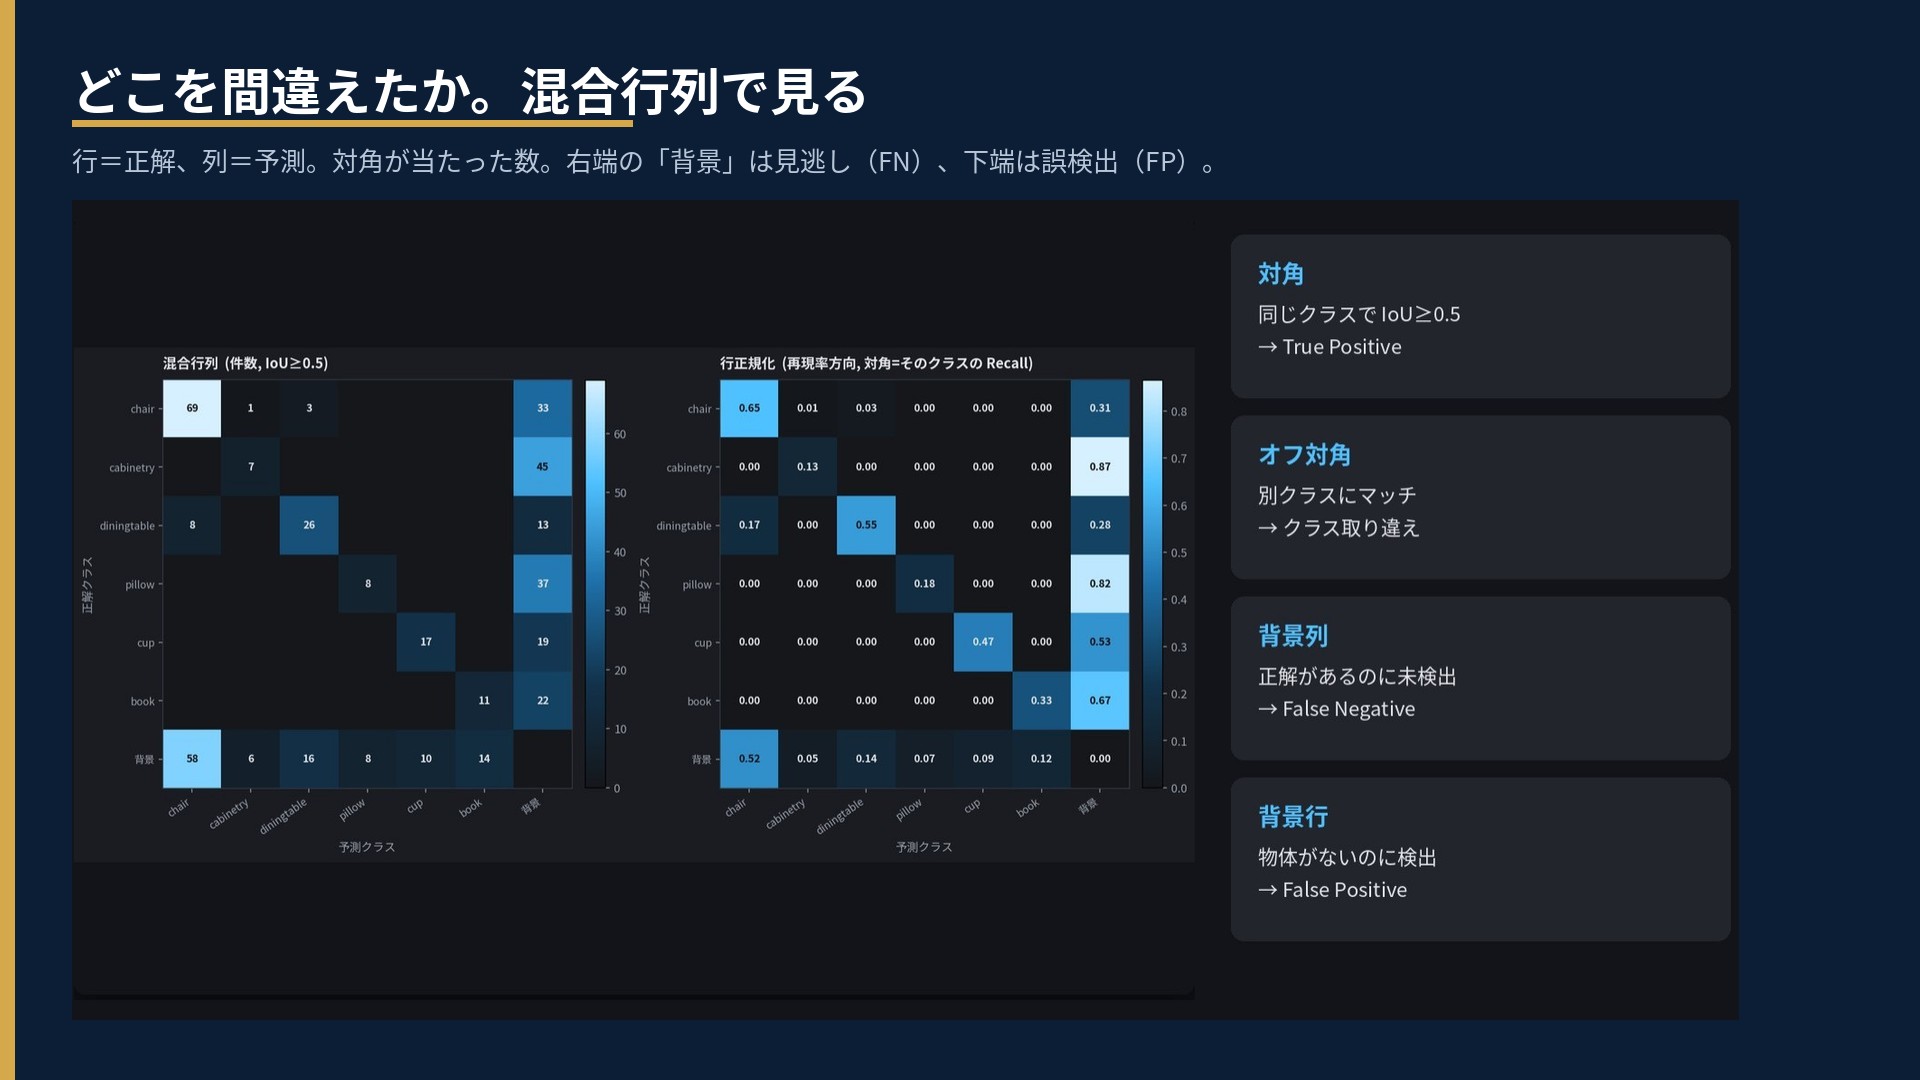
| 位置 | 意味 |
|---|---|
| 対角 | 同じクラスで IoU ≥ 0.5 → True Positive |
| オフ対角 | 別クラスにマッチ → クラス取り違え |
| 背景列 | 正解があるのに未検出 → False Negative |
| 背景行 | 物体がないのに検出 → False Positive |
mAP が同じでも、見逃しが多いのか、取り違えが多いのかで打ち手が違います。混合行列は、その切り分けのための図です。
重い依存は、別プロセス。アプリは薄い
認識スタックは依存が重いので、全部を一つのプロセスに積むと壊れます。RecogStudio はランタイムを5つに分け、GUI 本体は薄く保ちます。
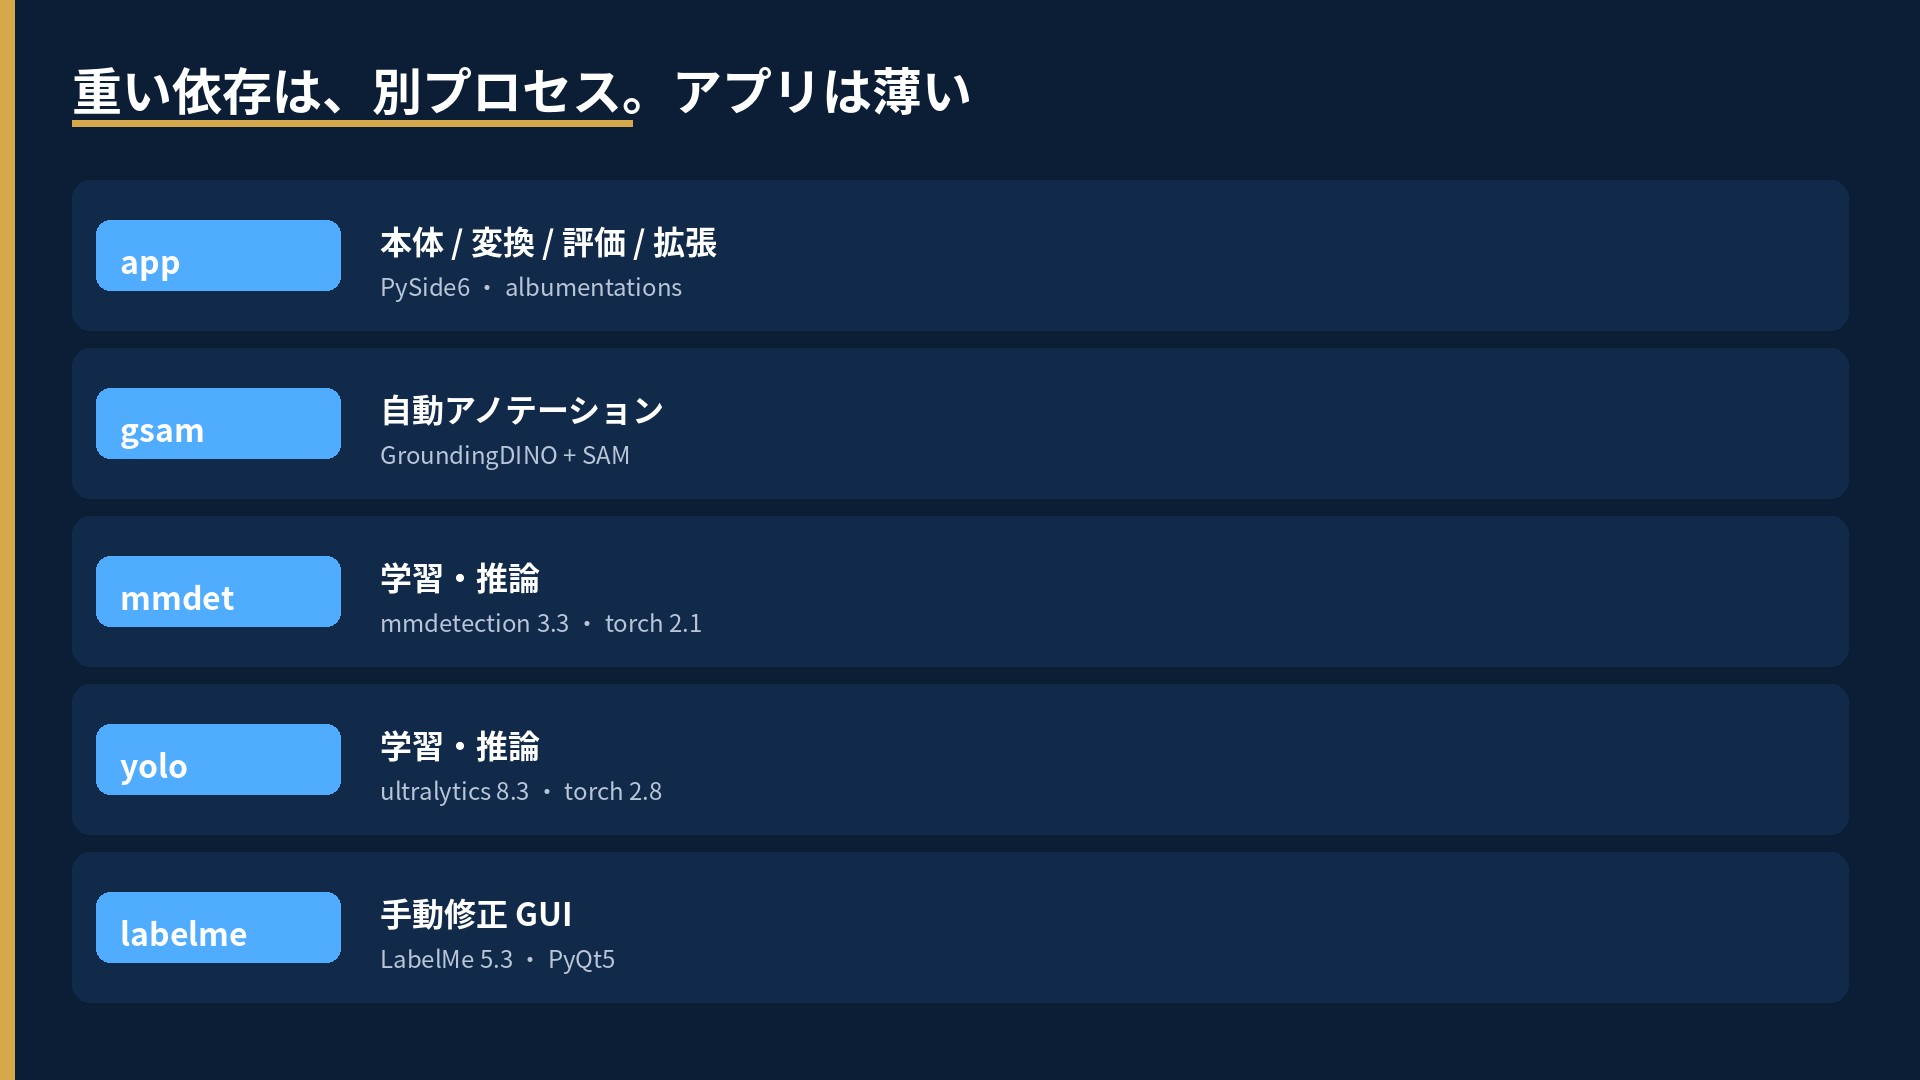
学習ジョブも推論も、同じエントリから再現できます。GUI が落ちても、ジョブ側は残ります。
画面で押したボタンは、同じコマンドになる
設計の約束はひとつです。新機能は、処理本体 → コマンド → 画面の順で足します。画面にしかない機能は作らない。だから、画面で押した操作は同じコマンドとして再現できます。
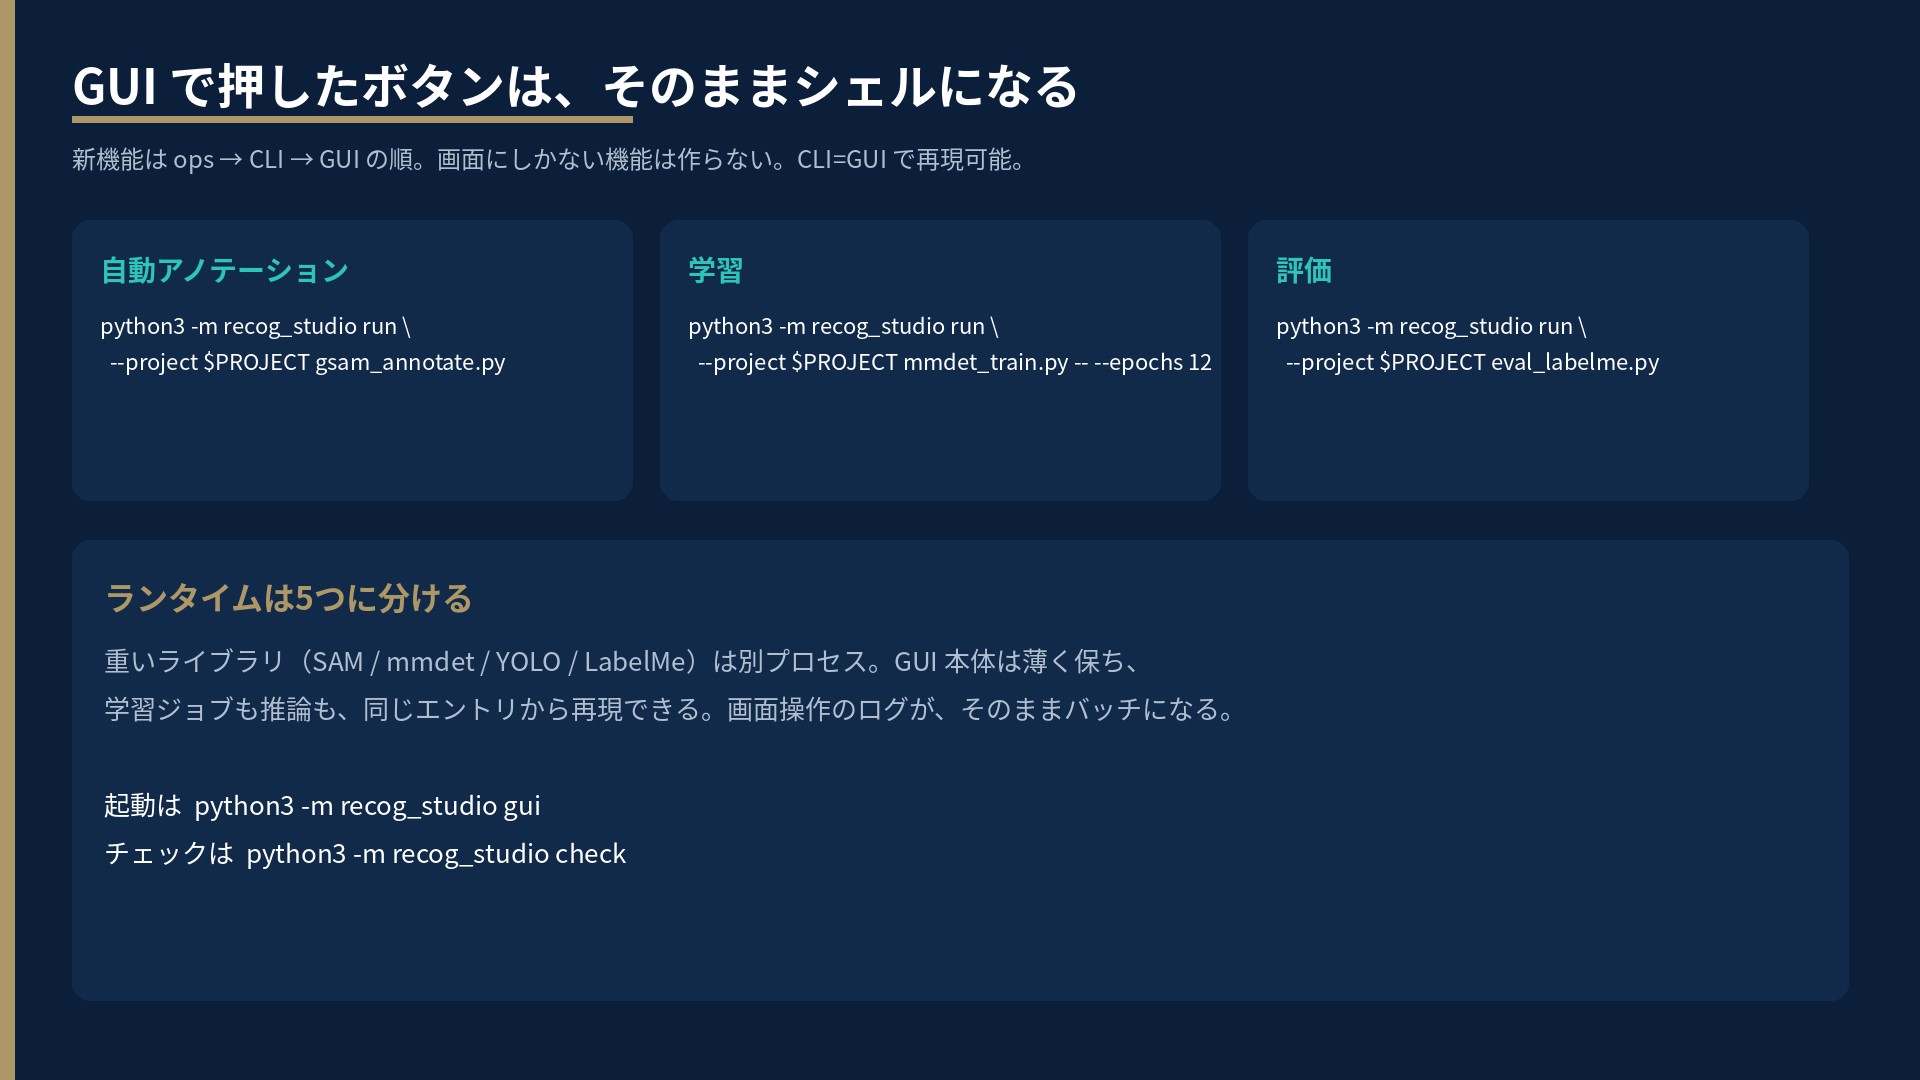
python3 -m recog_studio gui、依存の確認は python3 -m recog_studio check。プロジェクトパスは環境に合わせて渡します。これは「エンジニア向けの裏コマンドがある」という意味ではありません。画面でやったことが、明日のスクリプトになる という意味です。デモで押した学習が、夜間バッチと同じ入り口であれば、再現できない画面操作には戻りません。
まとめ
- 一本の流れ ― 取り込み・自動での印つけ・学習・評価・推論を、LabelMe 形式を共通の受け渡しにしてつなぐ。
- 9ステップ ― 左ナビを進めるだけ。COCO / YOLO / 動画 / Web から入れても、内部は LabelMe。
- 自動アノテはたたき台 ― GroundingDINO → SAM → JSON。人が直してから学習する。
- 学習は2系統 ― mmdetection と YOLO。評価は枠に依らず LabelMe vs LabelMe。
- 数字は並べて見る ― bbox mAP 0.609 / @0.5 0.860、segm mAP 0.655 / @0.75 0.733。PR・ROC・混合行列で動作点と弱点を切る。
- 画面とコマンドは同じ ― 重い処理は別プロセス。画面で押したボタンは、同じコマンドとして再現できます。
検出と輪郭切り出しの開発を、道具の渡り歩きから一本の流れへ戻す。RecogStudio は、そのための当社の認識開発の環境です。デモやご相談を承っています。